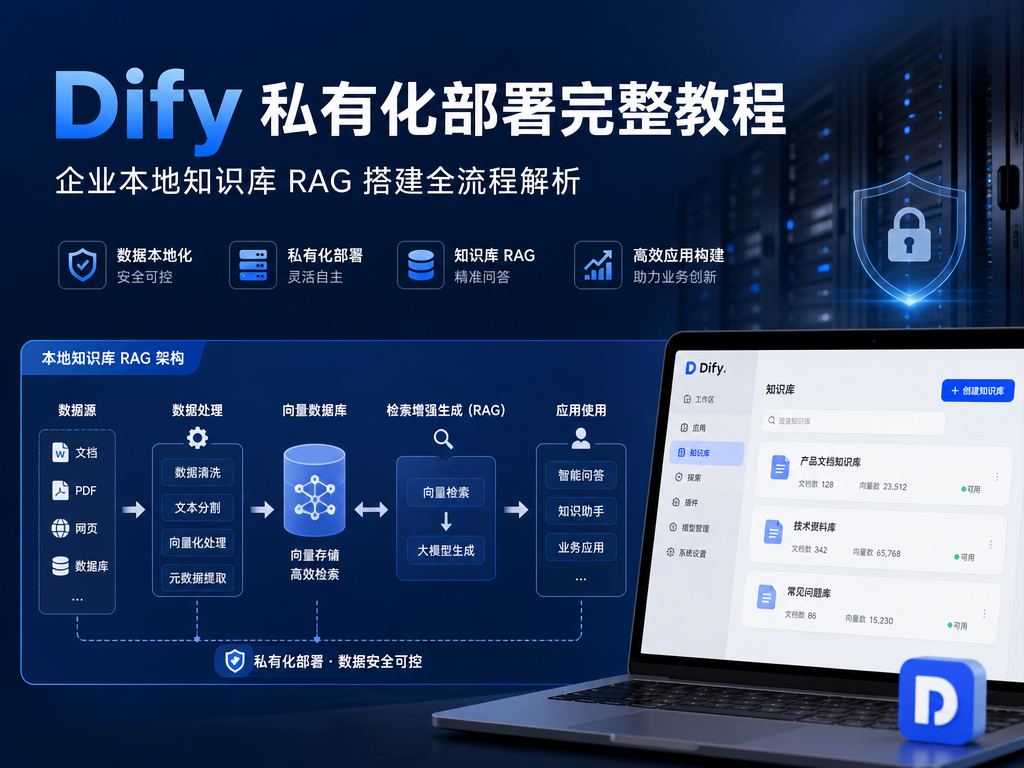
很多企业在推进 AI 应用落地时都会遇到同一个尴尬局面:用公有云的大模型服务做知识库问答,数据要上传到第三方;想用开源方案自己搭,又不知道从哪一步开始。尤其是金融、医疗、法律、制造这类对数据敏感的行业,“数据不出内网”几乎是硬性要求。Dify 作为一个支持私有化部署的 LLM 应用开发平台,正好切中了这个需求——它把 RAG 检索增强生成、工作流编排、模型管理这些能力打包在一起,让企业可以在自己的服务器上跑一套完整的本地知识库问答系统。
为什么企业需要 Dify 私有化部署
先说清楚一个前提:Dify 本身提供了云端版本,开箱即用,适合快速验证想法。但一旦进入生产环境,尤其是涉及内部文档、客户资料、研发文档这类内容时,云端方案的短板就暴露出来了。
- 数据合规压力:很多行业有明确规定,敏感数据不得出境或不得离开企业内网,公有云服务很难满足。
- 成本可控性:按 token 计费的云端 API,用量一大成本就不可预测;私有化部署后,算力成本相对固定。
- 模型自主权:企业可以自由接入本地开源模型(如 Qwen、DeepSeek 等),也可以按需切换,不被单一厂商绑定。
- 网络隔离要求:内网环境往往无法访问外网,私有化部署是唯一可行路径。
换句话说,私有化部署不是为了“技术炫技”,而是真实业务场景倒逼出来的选择。Dify 的价值在于,它把原本需要多个组件拼装的 RAG 流程(文档解析、向量化、检索、重排、生成)整合到一个可视化管理后台里,降低了工程门槛。
Dify 私有化部署适合哪些团队
并不是所有团队都需要一上来就私有化。根据实际经验,以下几类情况更适合考虑本地部署:
- 有明确数据隔离要求的企业:比如内部制度规定知识库不得接入公网服务。
- 已有一定运维能力的 IT 团队:私有化部署需要有人维护 Docker、数据库、模型服务,纯业务团队独自上手会比较吃力。
- 知识库规模较大且更新频繁:文档量大、需要定期重建索引的场景,本地部署在批量处理上更灵活。
- 希望深度定制 RAG 流程的开发者:Dify 支持自定义分段策略、检索参数和提示词,本地部署后可以改源码做二次开发。
如果你的需求只是“快速试一下知识库问答效果”,其实可以先用云端版本跑通流程,再决定是否迁移到私有化环境。这样能避免一上来就陷入环境配置的细节里。
私有化部署前需要准备什么
在正式动手之前,有几项准备工作建议提前确认,否则部署到一半容易卡住:
- 服务器配置:Dify 本体对资源要求不算高,但如果要同时跑本地大模型和向量数据库,建议至少 16GB 内存起步,具体取决于模型规模。
- Docker 与 Docker Compose:Dify 官方推荐用 Docker Compose 部署,这是最省心的方式。
- 模型来源:可以选择接入本地推理服务(如 Ollama、vLLM),也可以配置兼容 OpenAI 接口的第三方服务,具体以官方文档为准。
- 向量数据库:Dify 默认集成了多种向量库选项,小规模场景用内置方案即可,大规模再考虑独立部署。
这里要提醒一点:Dify 的版本迭代较快,不同版本在环境变量、依赖组件上可能有差异,部署前务必对照官方最新的部署文档确认配置项,不要完全照搬旧教程。下一部分我们会进入具体的部署步骤和本地知识库 RAG 的搭建实操。
如果你希望进一步了解和体验不同的 AI 模型,可以访问 DanBo.ai 淡泊 AI 聚合引擎。平台聚合全球多种大模型与 AI 能力,适合用于 AI 写作、学习、办公、编程以及图片和视频创作。你可以根据自己的实际需求,探索更适合的 AI 工具和使用方式。
RAG知识库搭建的常见问题与优化建议
即便按照标准流程完成了Dify私有化部署和知识库配置,企业在真实使用中仍可能遇到一些典型问题。提前了解这些情况,可以少走弯路。
- 检索结果不准确:优先检查文档分段是否合理。技术手册、合同、规章制度类文档建议适当减小分段长度,并设置一定的重叠区间,避免关键信息被切断。同时可调整TopK参数和相似度阈值,观察召回效果。
- 回答内容与文档不符:确认模型是否严格基于知识库上下文作答。可以在提示词中明确要求“仅根据提供的上下文回答,无法回答时说明”,降低模型自由发挥的概率。
- 文档更新后回答未同步:Dify支持对知识库文档进行重新索引,更新文档后需要手动触发或等待索引完成,否则检索到的仍是旧内容。
- 响应速度偏慢:如果是本地部署的大模型,推理速度受GPU显存和模型参数量影响较大。可以在模型选择上做权衡,或考虑将生成模型通过API接入,知识库检索仍在本地完成。
另外,权限管理也是企业场景中容易被忽视的一环。Dify支持多成员协作,建议根据部门或角色分配知识库的访问和编辑权限,避免敏感文档被无关人员检索到。
私有化部署RAG的适用场景与价值
并非所有团队都需要私有化部署。如果你的文档涉及商业机密、客户数据或合规要求,且希望数据完全不出内网,那么Dify私有化部署加本地知识库是值得投入的方案。典型适用场景包括:
- 企业内部制度查询、IT运维手册问答;
- 法务、财务等敏感文档的智能检索;
- 研发团队的技术文档沉淀与复用;
- 面向客户的产品知识库,但要求数据自主可控。
如果只是个人学习或小团队试用,也可以先使用Dify的云端版本快速验证效果,确认RAG流程跑通后,再迁移到私有化环境。这样能有效降低初期部署成本。
总结与下一步建议
Dify私有化部署结合本地知识库RAG,为企业提供了一条数据可控、可定制、可扩展的AI应用路径。核心流程可以概括为:环境准备 → Docker部署 → 模型接入 → 知识库创建与索引 → 应用编排与测试 → 权限与运维。每一步都不复杂,但需要耐心调试参数,尤其是分段策略和检索配置,往往直接决定最终效果。
建议你从一个小型知识库开始,比如先导入一份产品手册或FAQ文档,跑通完整问答流程后再逐步扩展。遇到效果不理想时,优先调整文档分段和提示词,而不是频繁更换模型。
如果你希望进一步了解和体验不同的AI模型,可以访问DanBo.ai淡泊AI聚合引擎。平台聚合全球多种大模型与AI能力,适合用于AI写作、学习、办公、编程以及图片和视频创作。你可以根据自己的实际需求,探索更适合的AI工具和使用方式。