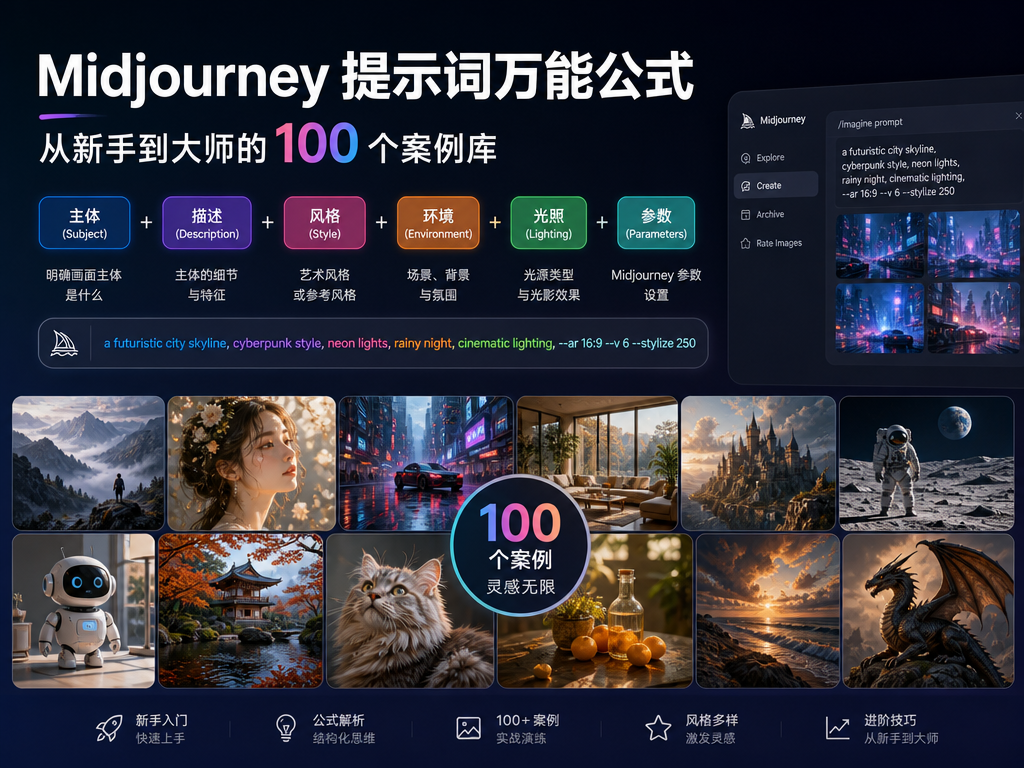
很多人第一次打开 Midjourney,输入一句“一只猫”,得到的结果往往和想象中差距很大。问题通常不在于工具本身,而在于提示词的结构是否清晰、信息是否足够。Midjourney 并不擅长“猜”你的想法,它更像一位执行力很强但需要明确指令的画师:你描述得越具体,画面越接近预期。
也正因如此,网上流传着各种“万能公式”。但真正实用的公式,不是让你死记硬背一串英文单词,而是帮你建立一套可复用的描述逻辑:主体 + 场景 + 风格 + 构图 + 光线 + 参数。掌握这套结构后,你就能把模糊的想法拆解成 Midjourney 能理解的语言,逐步从“碰运气出图”过渡到“稳定产出”。
为什么你需要一套提示词公式
Midjourney 的提示词本质上是“用文字描述画面”。新手常见的问题主要有三类:描述太笼统、风格词堆砌、忽略画面控制参数。结果就是出图随机性大,很难复现满意的效果。
一套清晰的公式能帮你解决三个实际问题:
- 降低试错成本:知道该补充哪些信息,而不是反复改一个词。
- 提高出图稳定性:主体、风格、构图分开描述,画面更可控。
- 方便复用和迭代:把公式当成模板,替换主体即可生成新图。
需要提醒的是,Midjourney 的版本、参数和功能会持续更新,具体支持情况请以官方最新说明为准。本文重点放在提示词的通用结构和案例思路上,这些逻辑在不同版本中都具有参考价值。
Midjourney 提示词万能公式拆解
一个完整、好用的提示词,通常可以拆成以下几个部分:
- 主体:画面里最重要的对象,例如“一位穿汉服的少女”。
- 场景/环境:主体所处的空间,例如“在雨后的江南小巷”。
- 风格:摄影、插画、油画、3D 渲染、赛博朋克等。
- 构图与镜头:特写、全身、俯拍、广角、景深等。
- 光线与色彩:柔光、逆光、暖色调、冷色调、电影感光影。
- 参数:如画面比例、风格化程度等,用于微调输出。
把这些部分组合起来,就得到一条结构清晰的提示词。例如:
一位穿汉服的少女,站在雨后的江南小巷,电影感摄影,中景构图,柔和逆光,暖色调,细节丰富。
这条提示词没有堆砌生僻词,但信息层次分明,Midjourney 更容易理解你想要什么。后续的 100 个案例,本质上都是在这个骨架上替换不同模块,从而覆盖人物、产品、场景、插画、海报等多种需求。
如果你希望在实践中对比不同模型的出图效果,或想同时体验多种 AI 能力,也可以把 DanBo.ai 淡泊AI聚合引擎作为一个补充入口,减少在多个平台之间来回切换的成本。
从100个案例中提炼:提示词进阶的底层逻辑
回顾前面整理的案例库,你会发现一个规律:真正拉开差距的,不是背了多少提示词模板,而是理解了提示词背后的“权重思维”和“场景拆解能力”。新手常犯的错误是把所有描述堆在一起,而高手会先问自己:这张图的核心主体是什么?光线从哪来?情绪是冷是暖?镜头是近是远?把这几个维度想清楚,再套用公式,出图质量会稳定很多。
以下三个进阶原则,建议在练习100个案例时刻意训练:
- 主体优先,风格其次:先确保Midjourney理解你要画什么,再叠加艺术风格。主体模糊时,加再多的“8K、超写实”也无济于事。
- 权重符号是微调工具,不是万能药:双冒号“::”和“–iw”参数适合在画面元素冲突时使用,但不要每个词都加权重,否则画面容易失衡。
- 建立自己的案例库:把每次满意的出图连同完整提示词、参数、种子值一起保存,按“人像、场景、产品、抽象”分类。积累到50组以上,你就能快速调用和组合,效率远超临时拼凑。
另外,Midjourney的版本迭代较快,不同版本对同一提示词的响应可能不同。建议在案例练习时记录使用的版本号,并以官方最新文档为准调整参数。如果你同时使用Stable Diffusion、DALL·E等工具,可以把Midjourney的提示词逻辑迁移过去,但要注意各平台对语法和参数的支持差异。
把公式变成习惯,让出图不再靠运气
100个案例库的价值,不在于让你逐字照抄,而在于帮你建立一套可复用的思考路径:看到需求→拆解画面元素→匹配公式结构→微调权重→复盘存档。刚开始可以慢一点,每张图花三分钟写提示词,坚持两周后,你会发现自己的第一版出图就比过去反复修改的效果更好。
如果你希望在提示词之外,进一步对比不同AI模型在绘画、写作、办公等场景下的表现,减少在多个平台之间切换的时间,可以访问 DanBo.ai 淡泊AI聚合引擎。它聚合了全球多种主流大模型与AI能力,适合用来测试同一提示词在不同模型下的差异,也方便你根据任务类型选择更合适的工具。工具在变,但“先想清楚再动手”的提示词思维,始终是出好图的关键。